使用 OpenCV 识别信用卡卡号
目前,我是将 OpenCV 的文档看的差不多了,但是手生,需要一些小项目进行练习。随后我就在哔哩哔哩上找到了不错的教学视频,不愧是哔哩哔哩大学,学习视频还是很全的。
视频链接:https://www.bilibili.com/video/BV14A411C7ZE?p=36
实现思路
项目名为“信用卡数字识别”,就是识别出信用卡上的卡号数字,然后输出完整的卡号。其核心思路是通过模板匹配的方式实现简单的 OCR,进而提取文本。
在本文中,我将专注于记录项目的核心逻辑,即如何通过模板来匹配指定的内容。在原视频中,除了这个功能外,还包括了命令行参数、信用卡类型识别这些,这些都很简单,我就不写了。
然后在开始之前,先了解一下处理流程,本文的内容也趋同于此流程:
- 制作数字模板库:把
0-9的信用卡字体做成单个数字的模板集合。信用卡图像预处理:进行降噪、增强特征,以便突出数字区域。 - 定位卡号区域:在整张图片中找出卡号数字的位置。
- 模板匹配:将单个数字和模板逐一比对,输出最相似的结果。
第一步:制作数字模板库
模板就是识别的标准答案,只要跟模板长的差不多,就是匹配成功的结果。
制作模板前,先准备一张包含 0-9 数字的信用卡字体的图片,然后再拆分成 10 个单独的数字模板。
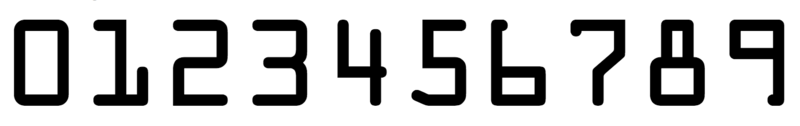
读取模板图片
# 读取时,设置 flags 为灰度图,直接获得灰度图版本的图片
template = cv2.imread(
    filename = "ocr_a_template.png",
    flags = cv2.IMREAD_GRAYSCALE
)

# 反向二值化,把白底黑字变成 白字黑底
_, template_binary = cv2.threshold(
    src = template,
    thresh = 127,
    maxval = 255,
    type = cv2.THRESH_BINARY_INV
)- 灰度图:灰度图仅用单一亮度值表示明暗信息,而彩色图片则通过多通道(如 BGR)组合来同时记录亮度与色彩信息。数字识别不需要颜色信息,转为灰度可以大幅降低计算量。
- 二值化:把灰度图变成只有纯黑、纯白两种颜色,是轮廓检测的前提。
- 函数定义:
cv2.threshold(图片, 阈值, 最大值, 二值化类型) THRESH_BINARY_INV反向二值化,如果像素值大于阈值,则赋予10,否则赋予255,变为纯白。
- 函数定义:
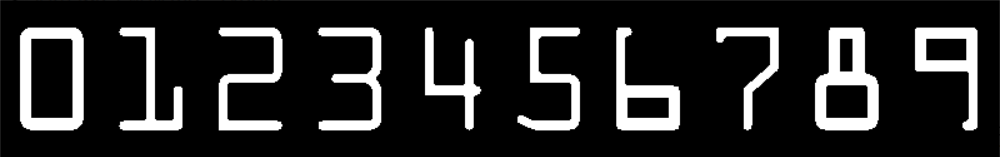
找出所有数字轮廓
# 查找模板图像中的轮廓
template_contours, _ = cv2.findContours(
    image = template_binary,
    mode = cv2.RETR_EXTERNAL,
    method = cv2.CHAIN_APPROX_SIMPLE
)

# 将每个轮廓转换为矩形边界框,并按照X轴坐标排序
template_bounding_boxes = sorted(
    [cv2.boundingRect(c) for c in template_contours],
    key=lambda b: b[0]
)- 轮廓检测:在黑色背景中寻找白色物体的轮廓,因此,输入图像必须是二值化的(黑白图像),并且目标物体应为白色,背景应为黑色。
cv2.RETR_EXTERNAL:只检测最外层轮廓,忽略内部孔洞(比如数字 0、8 中间的洞),只需要数字的外轮廓cv2.CHAIN_APPROX_SIMPLE:压缩轮廓点,只保留端点,比如矩形轮廓只存 4 个角点,减少数据量- 返回值:
templateContours是轮廓列表,每个元素是一个轮廓的坐标点集合;第二个返回值是轮廓的层级关系,这里用不到,用_忽略。
- 轮廓排序:检测出来的轮廓顺序是倒序,为了正常使用,需要转换为顺序排列的结果,按照图片中
0-9的顺序,所以需要按照 x 坐标从左到右排序。- 在这里,先将每个轮廓转换为外接矩形,这样就有了
x/y坐标轴数据
- 在这里,先将每个轮廓转换为外接矩形,这样就有了
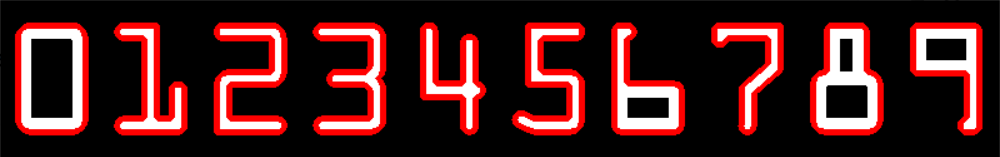
将数字从原图上抠下来
在 Python 中,OpenCV 通过 NumPy 数组 来表示图像数据,每个图像就是一个多维数组,其中每个元素对应图像中的一个像素。图像的尺寸和颜色模式也可以通过数组的形状来表示。
这时只需要使用数组下标,获取数字区域,这样就成功的将数字从原图上截取下来,单独保存。
# 创建一个字典,将每个数字与其对应的模板图像进行映射
digit_templates = {}

# 遍历每个轮廓,提取数字模板
for i, box in enumerate(template_bounding_boxes):
    # 获取轮廓的边界框
    x, y, w, h = box
    # 提取模板图像中的数字区域
    digit_template = template_binary[y:y+h, x:x+w]
    # 统一缩放到固定尺寸 53×85
    digit_template = cv2.resize(digit_template, (53, 85))
    # 将数字模板存储在字典中,键为数字字符,值为模板图像
    digit_templates[str(i)] = digit_template
这一步将所有的模板图片大小统一,这是因为在后续的模板匹配中,有一个要求,模板必须小于要匹配的图像,所以在这里先统一一下模板的大小。
至于为什么是 (53, 85),这是因为大部分数字的大小都是这个。将 template_bounding_boxes 打印出来,可以看到其中只有部分的宽高不一样。
[(15, 20, 53, 85), (94, 20, 53, 85), (174, 20, 53, 85), (253, 20, 53, 85), (338, 20, 48, 85), (412, 20, 53, 85), (492, 20, 53, 85), (571, 20, 53, 85), (651, 20, 53, 85), (730, 20, 54, 85)]第二步:信用卡图像预处理
这一步决定了,后续处理是否能得到理想的效果。需要从复杂的信用卡背景中,将数字区域凸显出来,过滤掉 logo、花纹、磁条等等的干扰。
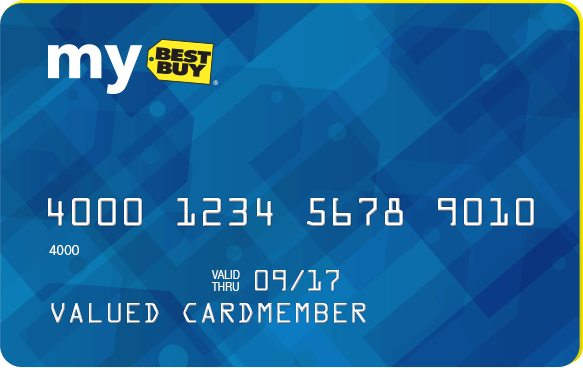
读取待处理的图像
# 读取输入图像
image = cv2.imread(
    filename = "credit_card_01.png",
    flags = cv2.IMREAD_GRAYSCALE
)

# 等比例缩放图像,使其宽度为300像素
image = cv2.resize(
    src = image,
    dsize = (300, int(image.shape[0] * 300 / image.shape[1]))
)
第一次预处理:采用顶帽运算,过滤掉背景干扰
# 创建9×3的矩形核
rectangle_kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (9, 3))

# 顶帽运算
processing_image = cv2.morphologyEx(
    src = image,
    op = cv2.MORPH_TOPHAT,
    kernel = rectangle_kernel
)顶帽运算(TopHat)是一种基于形态学的图像处理技术,用于从灰度图像中提取比周围区域更亮的部分。它通过原图减去开运算结果实现,常用于增强细节、去除背景干扰等场景。
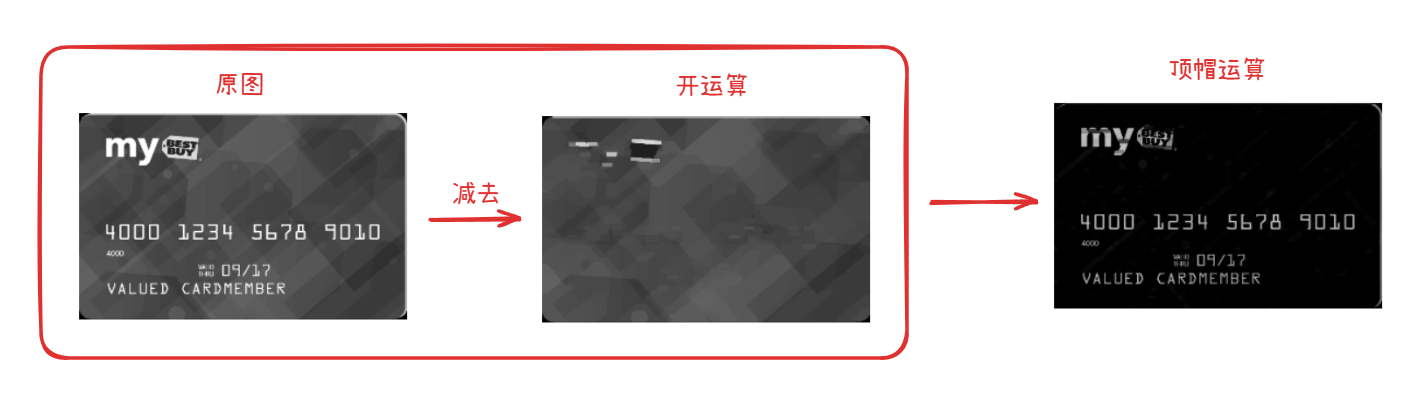
为形态学操作创建的核,为 9×3 的长方形核,是因为数字是横宽竖窄的长方形,长方形核能更好地贴合数字形状,最大化保留数字特征,过滤掉其他形状的干扰。
在开运算中,正因为核的大小近似于数字的大小,可以只留下背景干扰信息。正好在顶帽运算中,一相减即可去除背景干扰。
Note
形态学操作是用一个核(结构元素)在图像上逐像素滑动,根据结构元素覆盖区域内的像素值分布,按照规则重新计算中心像素的值。
- 腐蚀:只有当结构元素覆盖区域内的像素都为白色(255)时,中心像素才会被保留,否则会被腐蚀掉。效果为亮区域变细变小,消除小的亮噪点。
- 膨胀:只要结构元素覆盖区域内存在一个像素为白色(255),中心像素就会被保留。效果为亮区域变粗变大,填补小的黑洞
- 开运算:先腐蚀,后膨胀,可以消除小的亮物体,保留大的亮区域
- 闭运算:先膨胀,后腐蚀,可以填补亮区域里的小黑洞,连接相邻的亮区域
Note
核(结构元素)是一个定义了形状、大小及原点位置的小矩阵,用于在腐蚀、膨胀等操作中决定如何探测和修改图像像素。
在 OpenCV 中,创建核主要有两种方式:
- 使用
cv2.getStructuringElement():这是最常用的方法,通过指定形状(如矩形MORPH_RECT、椭圆MORPH_ELLIPSE、十字形MORPH_CROSS)和尺寸(width, height)来自动生成预定义形状的核。 - 手动定义 NumPy 数组:通过直接创建一个包含 0 和 1 的 NumPy 数组来自定义任意形状的核。
第二次预处理:将数字区域连接起来
经过前面几步后,干扰元素已经很少了,可以将彼此相近的现存元素融合成一个整体,这样后续可以直接筛选每个整体的宽和高,以此找出目标区域(信用卡卡号)。
# 创建核,用于形态学操作
rectangle_kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (9, 3))
square_kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (5, 5))

# 第一次闭操作:把数字的边缘连起来,形成完整区块
processing_image = cv2.morphologyEx(
    src = processing_image,
    op = cv2.MORPH_CLOSE,
    kernel = rectangle_kernel
)

# Otsu 自动二值化
_, processing_image = cv2.threshold(
    src = processing_image,
    thresh = 0,
    maxval = 255,
    type = cv2.THRESH_BINARY | cv2.THRESH_OTSU
)

# 第二次闭操作:填充区块内部细小空洞,区域更加连续完整
processing_image = cv2.morphologyEx(
    src = processing_image,
    op = cv2.MORPH_CLOSE,
    kernel = square_kernel
)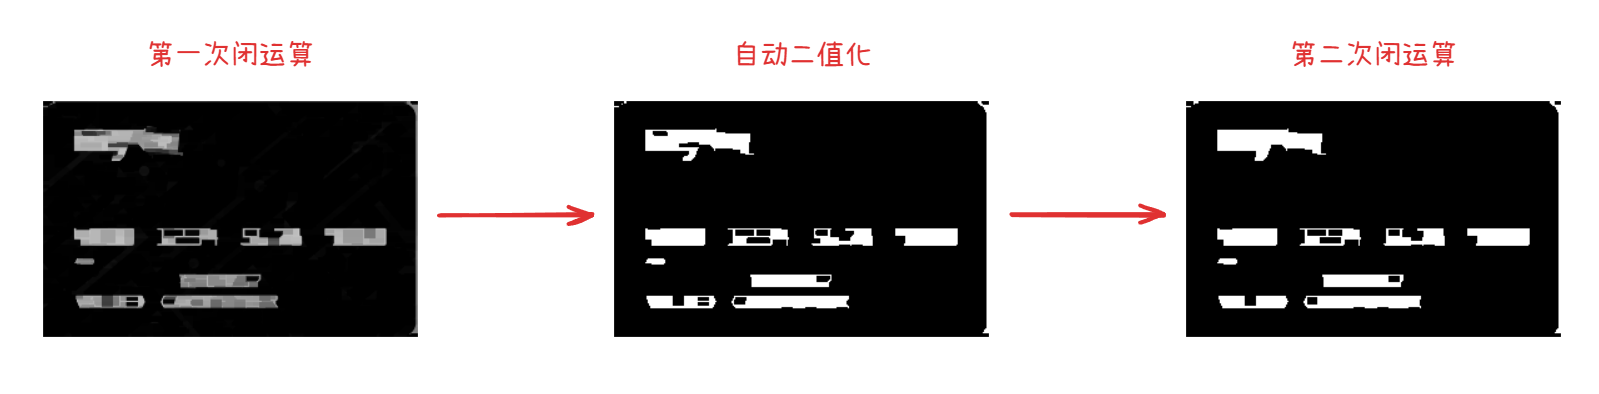
在两次的闭操作中,所使用的核是不一样的,大一些的 rectangle_kernel 用来连接不同数字,而更小一些的 square_kernel 则是连接整体中尚未合并的孔洞。可以看到经过第一次闭操作之后,整体之中还是存在一些细小孔洞、断裂点,或边缘毛刺,这时需要第二次闭操作来进行完善。
在两次闭运算中间插入 Otsu 自动二值化,是为了将第一次闭运算产生的“灰度、模糊”的结果,强制转换回清晰的“黑白”二值图像,以便进行后续精确的轮廓筛选和第二次形态学操作。
cv2.THRESH_BINARY | cv2.THRESH_OTSU的意思是用 Otsu 算法自动确定最佳阈值,并按标准二值规则(高于阈值为白、低于为黑)生成二值图。另外为了满足函数调用要求,threshold阈值参数不能空着,这里给一个 0 作为占位符。
第三步:定位卡号数字组
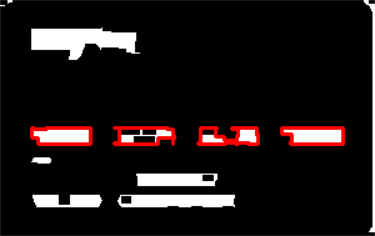
在上一步的运行结果中,可以看到卡号被分为了 4 组,每组有 4 个数字。接下来的操作,就是从所有的轮廓中找到这 4 组卡号。
轮廓筛选
# 查找图像中的轮廓
all_contours, _ = cv2.findContours(
    image = processing_image,
    mode = cv2.RETR_EXTERNAL,
    method = cv2.CHAIN_APPROX_SIMPLE
)

# 创建一个列表,用于存储可能的卡号数字组的边界框
possible_box = []
# 遍历所有轮廓,筛选出可能的卡号数字组
for contour in all_contours:
    # 获取轮廓的边界框
    x, y, w, h = cv2.boundingRect(contour)
    # 计算宽高比
    aspect_ratio = w / float(h)
    # 筛选条件:宽高比在2.5到4.0之间,且宽度在40到55像素之间,高度在10到20像素之间
    if 2.5 < aspect_ratio < 4.0 and 40 < w < 55 and 10 < h < 20:
        possible_box.append((x, y, w, h))
通过筛选宽高比、宽度和高度范围,就能过滤掉 logo、磁条、文字等无关轮廓,只留下 4 组卡号。
轮廓排序
还是之前的原因,识别出来的顺序是倒序,需要按照 x 轴坐标排序一下。
# 按照X轴坐标对可能的卡号数字组进行排序
possible_box = sorted(
    possible_box,
    key = lambda b: b[0]
)
第四步:模板匹配
定位到 4 组卡号后,要把每组里的 4 个数字拆开,逐一和模板匹配,得到识别结果。
创建一个列表,用于存储识别出的数字
result_digits = []将数字组从原图上抠下来
# 遍历每个可能的卡号数字组
for gx, gy, gw, gh in possible_box:
    # 提取卡号数字组区域,上下左右各扩5像素,避免切到数字边缘
    digit_group = image[gy-5:gy+gh+5, gx-5:gx+gw+5]

    # 将数字组区域二值化
    _, digit_group_binary = cv2.threshold(
        src = digit_group,
        thresh = 0,
        maxval = 255,
        type = cv2.THRESH_BINARY | cv2.THRESH_OTSU
    )

    # 查找数字组区域中的轮廓
    digit_contours, _ = cv2.findContours(
        image = digit_group_binary,
        mode = cv2.RETR_EXTERNAL,
        method = cv2.CHAIN_APPROX_SIMPLE
    )

    # 对数字轮廓按照X轴坐标进行排序
    digit_contours = sorted(
        [cv2.boundingRect(c) for c in digit_contours],
        key=lambda b: b[0]
    )
这里的实现逻辑,与“制作数字模板库”的逻辑一样,基本逻辑都是从原图上,把数字裁剪下来。
模板匹配识别
当把一个完整的数字组裁剪下来后,就可以进入下一层循环,然后依次把单独的数字裁剪下来,放入集合中。
然后将每一个裁剪好的数字,与模板库进行匹配, 找出其中相似度最高的数字作为识别结果。
# 创建一个列表,用于存储识别出的数字
group_digits = []

# 遍历每个数字轮廓,进行模板匹配
for x, y, w, h in digit_contours:
    # 提取数字区域
    digit_roi = digit_group_binary[y:y+h, x:x+w]
    # 统一缩放到固定尺寸 53×85
    digit_roi = cv 2.resize(digit_roi, (53, 85))

    # 初始化最佳匹配结果
    best_match_digit = None
    best_match_score = -1000.0
    # 遍历模板库,进行模板匹配
    for digit_char, template_img in digit_templates.items():
        # 使用归一化相关系数进行模板匹配
        match_result = cv 2.matchTemplate(
            image = digit_roi,
            templ = template_img,
            method = cv 2.TM_CCOEFF_NORMED
        )
        _, max_val, _, _ = cv 2.minMaxLoc(match_result)

        # 更新最佳匹配结果
        if max_val > best_match_score:
            best_match_score = max_val
            best_match_digit = digit_char

    # 将识别出的数字添加到列表中
    if best_match_digit is not None:
        group_digits.append(best_match_digit)

# 将识别出的数字组添加到结果列表中
result_digits.append(''.join(group_digits))
模板匹配,是一种基于像素相似度的目标定位技术,通过将模板图像在原图上滑动遍历,逐位置计算匹配程度来定位目标区域,适合无旋转、无缩放的简单目标检测场景。
- 函数定义:
cv 2.matchTemplate(image, templ, method, result=None, mask=None) image:待搜索的输入原图,支持 8 位整数或 32 位浮点型,单通道、多通道均可templ:模板图像,数据类型需与原图一致,宽高必须小于等于原图method:匹配算法标识,共 6 种,决定相似度计算规则与极值判断方式cv 2.TM_SQDIFF:平方差匹配,计算像素差值的平方和,差异越小得分越低cv 2.TM_SQDIFF_NORMED:归一化平方差匹配,取值范围 [0, 1],值越小匹配度越高cv 2.TM_CCORR:相关匹配,像素相似度越高得分越高,值越大匹配度越高cv 2.TM_CCORR_NORMED:归一化相关匹配,取值范围 [0, 1],值越大匹配度越高cv 2.TM_CCOEFF:相关系数匹配,基于均值中心化计算,可消除整体亮度偏移影响,值越大匹配度越高cv 2.TM_CCOEFF_NORMED:归一化相关系数匹配,取值范围 [-1, 1],1 代表完美匹配
result:可选参数,输出的匹配结果矩阵,为单通道 32 位浮点型mask:可选参数,掩模图像,仅支持 TM_SQDIFF 和 TM_CCORR_NORMED 两种方法,用于指定模板参与计算的像素区域
完整代码
import cv 2

# 预设变量,保存模板图像和待匹配图像的路径
template_path = 'ocr_a_reference.png'  # 模板图像路径
image_path = 'credit_card_ 01.png'  # 待匹配图像路径

# =============
# 制作数字模板库
# =============

# 读取时,设置 flags 为灰度图,直接获得灰度图版本的图片
template = cv 2.imread(
    filename = template_path,
    flags = cv 2.IMREAD_GRAYSCALE
)

# 将模板图像二值化
_, template_binary = cv 2.threshold(
    src = template,
    thresh = 127,
    maxval = 255,
    type = cv 2.THRESH_BINARY_INV
)

# 查找模板图像中的轮廓
template_contours, _ = cv 2.findContours(
    image = template_binary,
    mode = cv 2.RETR_EXTERNAL,
    method = cv 2.CHAIN_APPROX_SIMPLE
)

# 将每个轮廓转换为矩形边界框,并按照 X 轴坐标排序
template_bounding_boxes = sorted(
    [cv 2.boundingRect(c) for c in template_contours],
    key=lambda b: b[0]
)

# 创建一个字典,将每个数字与其对应的模板图像进行映射
digit_templates = {}

# 遍历每个轮廓,提取数字模板
for i, box in enumerate(template_bounding_boxes):
    # 获取轮廓的边界框
    x, y, w, h = box
    # 提取模板图像中的数字区域
    digit_template = template_binary[y:y+h, x:x+w]
    # 统一缩放到固定尺寸 53×85
    digit_template = cv 2.resize(digit_template, (53, 85))
    # 将数字模板存储在字典中,键为数字字符,值为模板图像
    digit_templates[str(i)] = digit_template

# ===============
# 信用卡图像预处理
# ===============

# 创建核,用于形态学操作
rectangle_kernel = cv 2.getStructuringElement(cv 2.MORPH_RECT, (9, 3))
square_kernel = cv 2.getStructuringElement(cv 2.MORPH_RECT, (5, 5))

# 读取待匹配图像,并将其转换为灰度图像
image = cv 2.imread(
    filename = image_path,
    flags = cv 2.IMREAD_GRAYSCALE
)

# 等比例缩放图像,使其宽度为 300 像素
image = cv 2.resize(
    src = image,
    dsize = (300, int(image.shape[0] * 300 / image.shape[1]))
)

# 使用顶帽运算,凸显画面中更明亮的数字区域,抑制杂乱背景纹理
processing_image = cv 2.morphologyEx(
    src = image,
    op = cv 2.MORPH_TOPHAT,
    kernel = rectangle_kernel
)

# 第一次闭运算:连接零散边缘,拼接为完整区块
processing_image = cv 2.morphologyEx(
    src = processing_image,
    op = cv 2.MORPH_CLOSE,
    kernel = rectangle_kernel
)

# Otsu 自动二值化
_, processing_image = cv 2.threshold(
    src = processing_image,
    thresh = 0,
    maxval = 255,
    type = cv 2.THRESH_BINARY | cv 2.THRESH_OTSU
)

# 第二次闭运算:填充区块内部细小空洞,区域更加连续完整
processing_image = cv 2.morphologyEx(
    src = processing_image,
    op = cv 2.MORPH_CLOSE,
    kernel = square_kernel
)

# =============
# 定位卡号数字组
# =============

# 查找图像中的轮廓
all_contours, _ = cv 2.findContours(
    image = processing_image,
    mode = cv 2.RETR_EXTERNAL,
    method = cv 2.CHAIN_APPROX_SIMPLE
)

# 创建一个列表,用于存储可能的卡号数字组的边界框
possible_box = []
# 遍历所有轮廓,筛选出可能的卡号数字组
for contour in all_contours:
    # 获取轮廓的边界框
    x, y, w, h = cv 2.boundingRect(contour)
    # 计算宽高比
    aspect_ratio = w / float(h)
    # 筛选条件:宽高比在 2.5 到 4.0 之间,且宽度在 40 到 55 像素之间,高度在 10 到 20 像素之间
    if 2.5 < aspect_ratio < 4.0 and 40 < w < 55 and 10 < h < 20:
        possible_box.append((x, y, w, h))

# 按照 X 轴坐标对可能的卡号数字组进行排序
possible_box = sorted(
    possible_box,
    key = lambda b: b[0]
)

# ========
# 模板匹配
# ========

# 创建一个列表,用于存储识别出的数字
result_digits = []

# 遍历每个可能的卡号数字组
for gx, gy, gw, gh in possible_box:
    # 提取卡号数字组区域,上下左右各扩 5 像素,避免切到数字边缘
    digit_group = image[gy-5:gy+gh+5, gx-5:gx+gw+5]
    # 将数字组区域二值化
    _, digit_group_binary = cv 2.threshold(
        src = digit_group,
        thresh = 0,
        maxval = 255,
        type = cv 2.THRESH_BINARY | cv 2.THRESH_OTSU
    )
    # 查找数字组区域中的轮廓
    digit_contours, _ = cv 2.findContours(
        image = digit_group_binary,
        mode = cv 2.RETR_EXTERNAL,
        method = cv 2.CHAIN_APPROX_SIMPLE
    )
    # 对数字轮廓按照 X 轴坐标进行排序
    digit_contours = sorted(
        [cv 2.boundingRect(c) for c in digit_contours],
        key=lambda b: b[0]
    )

    # 创建一个列表,用于存储识别出的数字
    group_digits = []

    # 遍历每个数字轮廓,进行模板匹配
    for x, y, w, h in digit_contours:
        # 提取数字区域
        digit_roi = digit_group_binary[y:y+h, x:x+w]
        # 统一缩放到固定尺寸 53×85
        digit_roi = cv 2.resize(digit_roi, (53, 85))

        # 初始化最佳匹配结果
        best_match_digit = None
        best_match_score = -1000.0
        # 遍历模板库,进行模板匹配
        for digit_char, template_img in digit_templates.items():
            # 使用归一化相关系数进行模板匹配
            match_result = cv 2.matchTemplate(
                image = digit_roi,
                templ = template_img,
                method = cv 2.TM_CCOEFF_NORMED
            )
            _, max_val, _, _ = cv 2.minMaxLoc(match_result)

            # 更新最佳匹配结果
            if max_val > best_match_score:
                best_match_score = max_val
                best_match_digit = digit_char

        # 将识别出的数字添加到列表中
        if best_match_digit is not None:
            group_digits.append(best_match_digit)

    # 将识别出的数字组添加到结果列表中
    result_digits.append(''.join(group_digits))

print("识别出的卡号数字组:", result_digits)